Ljud och taligenkänning

Agenten hörde två röster. Den trodde att båda var kunden.

Ett telefonsamtal kommer in som en enda ljudkanal, och allt mikrofonen fångar upp hamnar i den: kunden, den som sitter vid köksbordet, radion – och agentens egen röst som kommer tillbaka. Varför det är ett av de svåraste problemen i en röstagent, förklarat utan fackspråk.

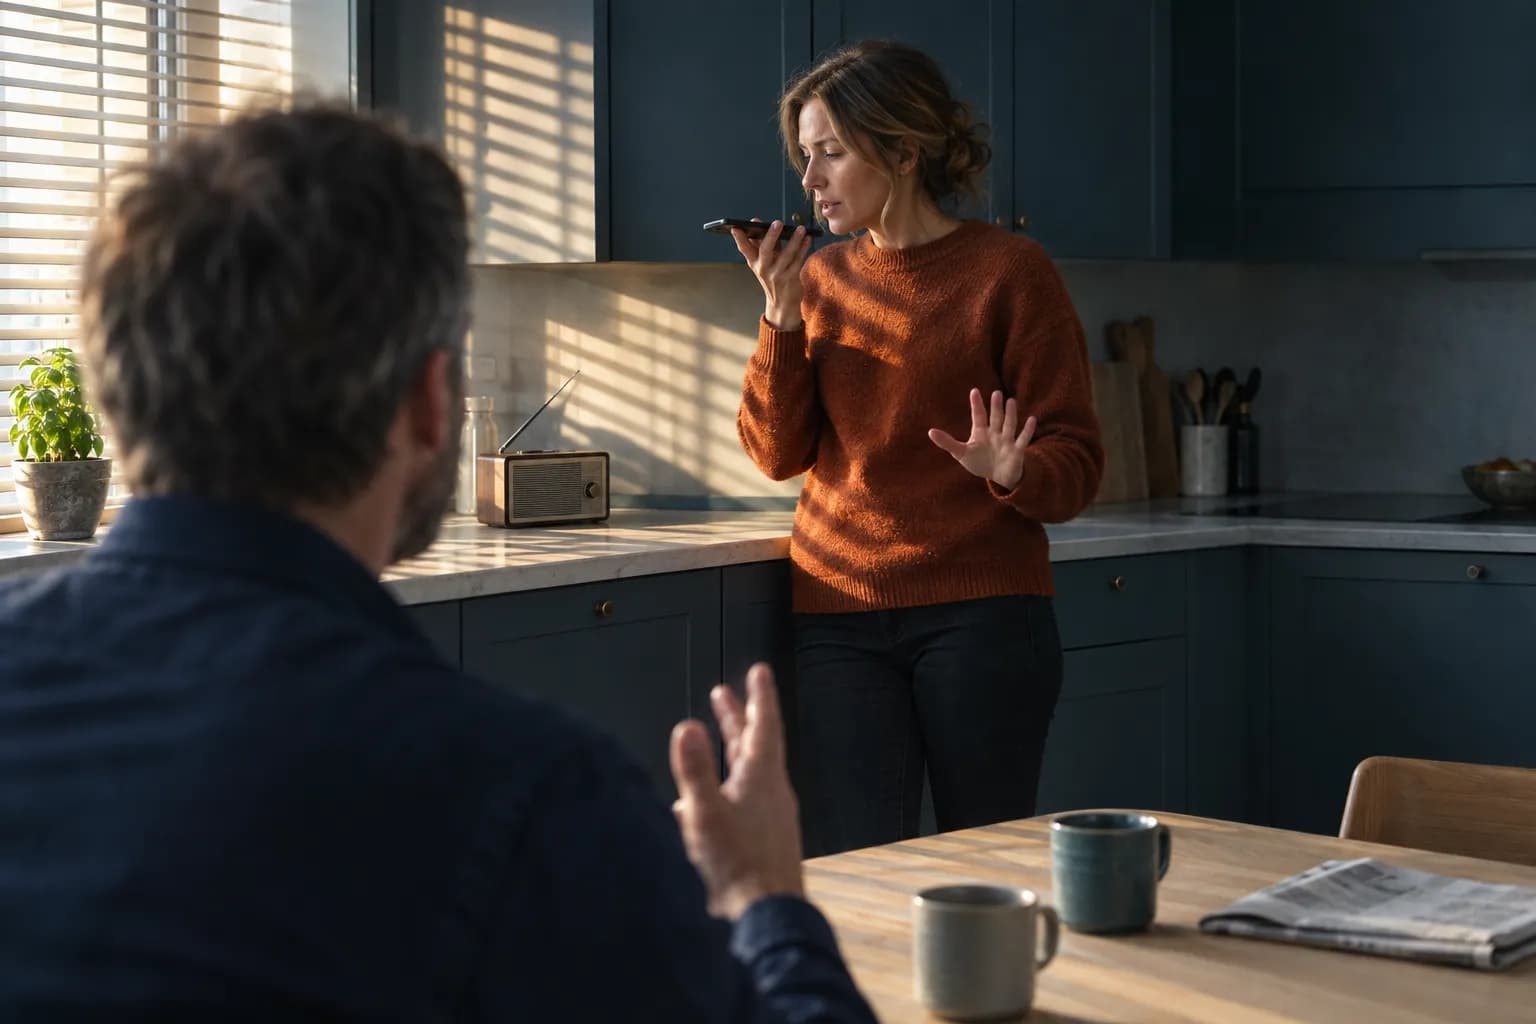
Sett över axeln på en man vid ett köksbord: en kvinna i roströd stickad tröja står vid köksbänken och pratar i mobilen som hon håller platt framför munnen, med andra handen lyft mot mannen, som gestikulerar mot henne. Eftermiddagssol genom persienner faller över bänken och en liten radio.

Kunden ringer för att flytta en tid. Hon står vid köksbänken med telefonen på högtalare. Agenten föreslår torsdag klockan 14. Hon säger ”ja, det …”, och i samma ögonblick säger hennes man vid bordet ”nej, på torsdag ska vi ju till mamma”.

Agenten har fått två svar på en fråga, från två människor, i samma ljudström. Den vet inte att de är två.

Måndagen den 28 september lanserade Fish Audio transkriberingsmodellen transcribe-1-pro, som markerar vem som talar i en inspelning. Den lägger in numrerade talarmarkeringar och markörer som ”[skratt]” direkt i texten, för 0,36 dollar per ljudtimme. Det är användbart. Det är också en bra ingång för att förklara varför problemet är så mycket svårare medan samtalet pågår än efteråt.

En kanal, alla röster

Ett vanligt telefonsamtal är en enda ljudkanal. Telefonen fångar upp det mikrofonen hör och skickar det vidare som en ström. Det finns inget eget spår för kunden och ett annat för resten av rummet. Linjen slänger dessutom bort en stor del av ljudet på vägen, så det som når agenten är både smalare och mer blandat än det kunden själv hör.

Taligenkänningen gör det den är byggd för: den skriver ner tal. Den skiljer inte på tal som är riktat till agenten och tal som bara förekommer i närheten. Fyra källor återkommer:

Vad som finns i rummet Vad agenten gör fel Vad som hjälper
En annan person som pratar Tar en kommentar till kunden som ett svar Att läsa tillbaka viktiga uppgifter och vänta på ett ja
Radio, tv eller musik i bakgrunden Skriver ner ord som ingen sa till den, eller tror att kunden avbryter Att kräva mer än ett par stavelser innan agenten tystnar
Agentens egen röst i retur Hör sig själv och avbryter sig själv Ekosläckning, testad med högtalare och i bil
Ett öppet kontorslandskap Blandar in kollegornas samtal Att klara av att kunden säger ”vänta lite”

Agenten som avbryter sig själv

Den tredje raden överraskar flest. När kunden har telefonen på högtalare eller pratar genom bilens handsfree kommer agentens röst ut ur en högtalare några centimeter från mikrofonen. Telefonen försöker dra bort det ljudet igen – det kallas ekosläckning – och den är bra, men inte felfri. Det som släpps igenom går tillbaka till agenten.

En agent som är inställd på att sluta prata så fort den hör tal gör då precis det: den tystnar mitt i en mening för att den hörde sig själv. För kunden låter det som en agent som hackar, eller som aldrig låter henne få ett helt svar.

Samma inställning avgör vad som händer med radion. Är tröskeln för låg tystnar agenten för varje röst i bakgrunden. Är den för hög pratar den över kunden när hon faktiskt vill avbryta. Det finns inget enda rätt värde. Det måste provas på de samtal ni faktiskt får.
Vill du prata med någon som har gjort det här förut?

Femton minuter på telefon eller video. Vi säger ärligt om en röstagent passar er – och vad som måste vara klart innan den går i drift.

15 minuter · förutsättningslöst · välj tid själv

Varför det är lättare efteråt

Att skilja talare åt i en färdig inspelning är en annan uppgift än att göra det medan samtalet pågår. Efteråt har modellen hela samtalet. Den kan höra att röst nummer två dyker upp om och om igen, jämföra och gå tillbaka. Under samtalet har agenten några få stavelser och en bråkdel av en sekund på sig att avgöra om den ska svara.

Fish Audio skriver själva att talarnumren bara gäller inom en och samma inspelning. De säger inte vem personen är – och inte heller vem av dem som håller i telefonen.

Det betyder inte att markeringen saknar värde. Den hör hemma i genomgången efteråt. Med talarmarkeringar i spåret över vad agenten sa går det att hitta de samtal där en annan röst än kundens styrde utfallet. Det är en bättre utgångspunkt för att justera uppsättningen än en samlad felfrekvens.

Lösningen är inte bara ljudbehandling

Den mest robusta lösningen ligger i samtalsdesignen. Varje moment i samtalet har sin egen punkt där det kan gå sönder, och här finns det tre vanor som tar hand om det mesta:

Bekräfta det som kostar något. Tid, datum, namn och belopp läses tillbaka, och agenten väntar på ett tydligt ja: ”Då flyttar jag din tid till fredag klockan tio. Stämmer det?” En fråga som riktas direkt till den som ringer besvaras oftast av den som ringer.

Lägg märke till motsägelser. Kommer det två olika svar på samma fråga inom ett par sekunder är det en signal i sig. Agenten bör fråga en gång till i stället för att välja det sista den hörde.

Klara av ”vänta lite”. Kunder pratar ofta med någon annan mitt i samtalet. En agent som förstår ”vänta lite” och ”jag måste bara fråga min man”, och som då väntar i stället för att tolka det som sägs därefter, har löst en stor del av problemet.

Testa där kunderna faktiskt ringer ifrån

En uppsättning som har testats från ett tyst mötesrum med hörlurar har testats under de bästa förhållanden den någonsin kommer att möta. Ring hellre ert eget nummer från bilen med handsfree, från köket med radion på och med telefonen på högtalare medan en kollega pratar bredvid. Lyssna efter om agenten tystnar när den inte ska. Läs transkriberingen efteråt: står det ord där som ingen sa till agenten?

Kunder ringer sällan från ett tyst rum. Agenten hör bara en linje, men den måste bete sig som om den vet att den inte är ensam i samtalet.

Threll.ai bygger röstagenter på svenska, norska och danska. Testet ovan tar en halvtimme, och det kan göras i dag.