Lyd og talegjenkjenning

Agenten hørte to stemmer. Den trodde begge var kunden.

En telefonsamtale kommer inn som én lydkanal, og alt mikrofonen fanger opp, havner i den: kunden, den som sitter ved kjøkkenbordet, radioen – og agentens egen stemme i retur. Hvorfor det er et av de vanskeligste problemene i en stemmeagent, forklart uten fagspråk.

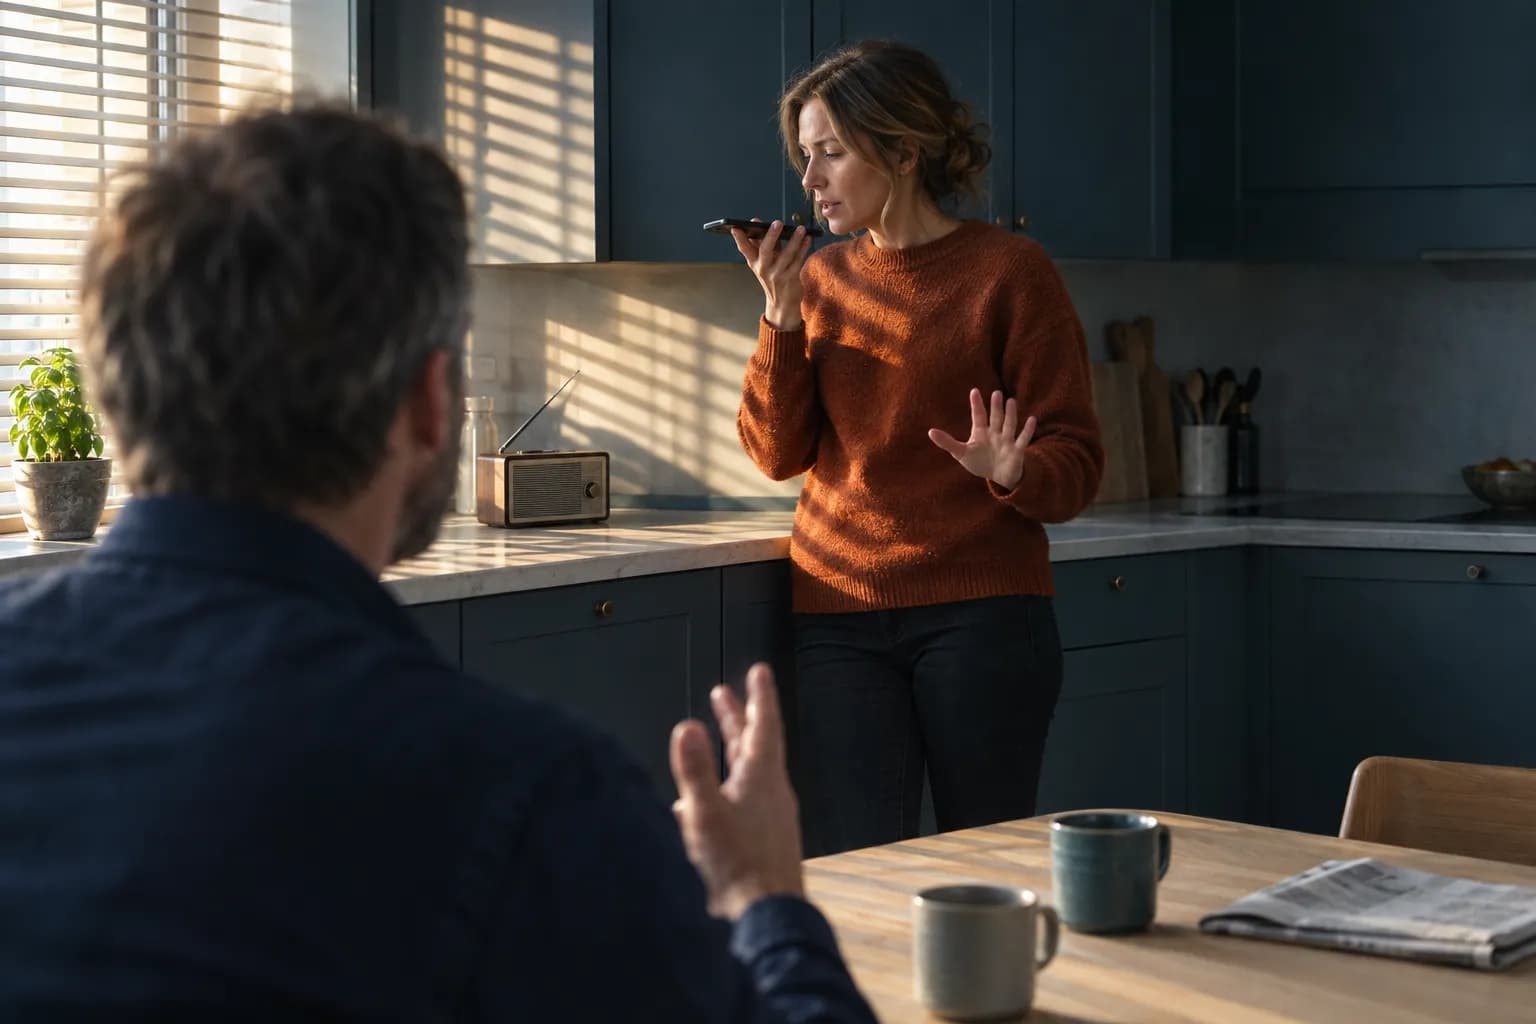
Sett over skulderen på en mann ved et kjøkkenbord: en kvinne i rustrød strikkegenser står ved benken og snakker inn i mobilen hun holder flatt foran munnen, med den andre hånden løftet mot mannen, som gestikulerer mot henne. Ettermiddagssol gjennom persienner faller over benken og en liten radio.

Kunden ringer for å flytte en time. Hun står ved kjøkkenbenken med telefonen på høyttaler. Agenten foreslår torsdag klokka 14. Hun sier «ja, det …», og i samme øyeblikk sier mannen hennes ved bordet «nei, torsdag skal vi jo til mor».

Agenten har fått to svar på ett spørsmål, fra to mennesker, i den samme lydstrømmen. Den vet ikke at det er to.

Mandag 28. september lanserte Fish Audio transkripsjonsmodellen transcribe-1-pro, som merker hvem som snakker i et opptak. Den setter inn nummererte talermerker og markører som «[latter]» rett i teksten, til 0,36 dollar per lydtime. Det er nyttig. Det er også et godt utgangspunkt for å forklare hvorfor problemet er så mye vanskeligere mens samtalen pågår enn etterpå.

Én kanal, alle stemmer

En vanlig telefonsamtale er én lydkanal. Telefonen fanger opp det mikrofonen hører og sender det videre som én strøm. Det finnes ikke et eget spor for kunden og et annet for resten av rommet. Linja kaster dessuten bort en god del av lyden underveis, så det som når agenten, er både smalere og mer blandet enn det kunden selv hører.

Talegjenkjenningen gjør det den er laget for: den skriver ned tale. Den skiller ikke mellom tale som er ment for agenten, og tale som bare skjer i nærheten. Fire kilder går igjen:

Hva som er i rommet Hva agenten gjør feil Hva som hjelper
En annen person som snakker Tar en kommentar til kunden som et svar Bekrefte viktige opplysninger tilbake og vente på et ja
Radio, TV eller musikk i bakgrunnen Skriver ned ord ingen sa til den, eller tror kunden avbryter Kreve mer enn et par stavelser før agenten stopper
Agentens egen stemme i retur Hører seg selv og avbryter seg selv Ekkodemping, testet med høyttaler og bil
Et åpent kontorlandskap Blander inn kollegers samtaler Tåle at kunden sier «vent litt»

Agenten som avbryter seg selv

Den tredje raden overrasker flest. Når kunden har telefonen på høyttaler eller snakker gjennom bilens handsfree, kommer agentens stemme ut av en høyttaler noen centimeter fra mikrofonen. Telefonen prøver å trekke den lyden fra igjen – det kalles ekkodemping – og den er god, men ikke feilfri. Det som slipper gjennom, går tilbake til agenten.

En agent som er satt opp til å slutte å snakke straks den hører tale, gjør da nøyaktig det: den stopper midt i en setning fordi den hørte seg selv. For kunden høres det ut som en agent som hakker, eller som aldri lar henne få et helt svar.

Den samme innstillingen avgjør hva som skjer med radioen. Er terskelen for lav, stopper agenten for hver stemme i bakgrunnen. Er den for høy, snakker den over kunden når hun faktisk vil avbryte. Det finnes ikke én riktig verdi. Den må prøves på de samtalene dere faktisk får.
Vil du snakke med noen som har gjort dette før?

Femten minutter på telefon eller video. Vi sier ærlig fra om en stemmeagent passer for dere – og hva som må være avklart før den settes i drift.

15 minutter · uforpliktende · velg tid selv

Hvorfor det er lettere etterpå

Å skille talere i et ferdig opptak er en annen oppgave enn å gjøre det mens samtalen pågår. Etterpå har modellen hele samtalen. Den kan høre at stemme nummer to dukker opp igjen og igjen, sammenligne og gå tilbake. Under samtalen har agenten noen få stavelser og en brøkdel av et sekund til å avgjøre om den skal svare.

Fish Audio skriver selv at talernumrene bare gjelder innenfor ett opptak. De sier ikke hvem personen er – og heller ikke hvem av dem som holder telefonen.

Det betyr ikke at merkingen er uten verdi. Den hører hjemme i gjennomgangen etterpå. Med talermerker i sporet over hva agenten sa blir det mulig å finne samtalene der en annen stemme enn kundens styrte utfallet. Det er et bedre utgangspunkt for å justere oppsettet enn en samlet feilrate.

Det som løser det, er ikke bare lydbehandling

Den mest robuste løsningen ligger i samtaledesignet. Hvert ledd i samtalen har sitt eget punkt der den kan ryke, og her er det tre vaner som tar det meste:

Bekreft det som koster noe. Tid, dato, navn og beløp sies tilbake, og agenten venter på et tydelig ja: «Da flytter jeg timen til fredag klokka ti. Stemmer det?» Et spørsmål rettet direkte til den som ringer, blir som regel besvart av den som ringer.

Legg merke til motsigelser. Kommer det to ulike svar på det samme spørsmålet i løpet av et par sekunder, er det et signal i seg selv. Agenten bør spørre én gang til, i stedet for å velge det siste den hørte.

Tål «vent litt». Kunden snakker ofte med noen andre midt i samtalen. En agent som forstår «vent litt» og «jeg må bare spørre mannen min», og som da venter i stedet for å tolke det som blir sagt videre, har løst en stor del av problemet.

Test det der kundene faktisk ringer fra

Et oppsett som er testet fra et stille møterom med hodetelefoner, er testet under de beste forholdene det noen gang kommer til å møte. Ring heller deres eget nummer fra bilen med handsfree, fra kjøkkenet med radioen på, og med telefonen på høyttaler mens en kollega snakker ved siden av. Hør om agenten stopper når den ikke skal. Les transkripsjonen etterpå: står det ord der som ingen sa til den?

Kunden ringer sjelden fra et stille rom. Agenten hører bare én linje, men den må oppføre seg som om den vet at den ikke er alene i samtalen.

Threll.ai bygger stemmeagenter på norsk, svensk og dansk. Testen over tar en halvtime, og den kan gjøres i dag.